Il y a des projets qui commencent par une simple curiosité, quelques tests et l’envie de voir jusqu’où on peut pousser son infrastructure. Et puis il y a ceux qui finissent par vous surprendre bien au-delà de vos attentes. C’est exactement ce qui m’arrive avec STRATA et Qwen3.8-Flash-Next.
Après avoir passé pas mal de temps à expérimenter différents modèles locaux sur mon infrastructure Athena, j’ai décidé de franchir une nouvelle étape. L’objectif était assez simple : tester un modèle nettement plus ambitieux, améliorer les capacités de mon agent Pi et voir si mon HomeLab pouvait encaisser la charge.
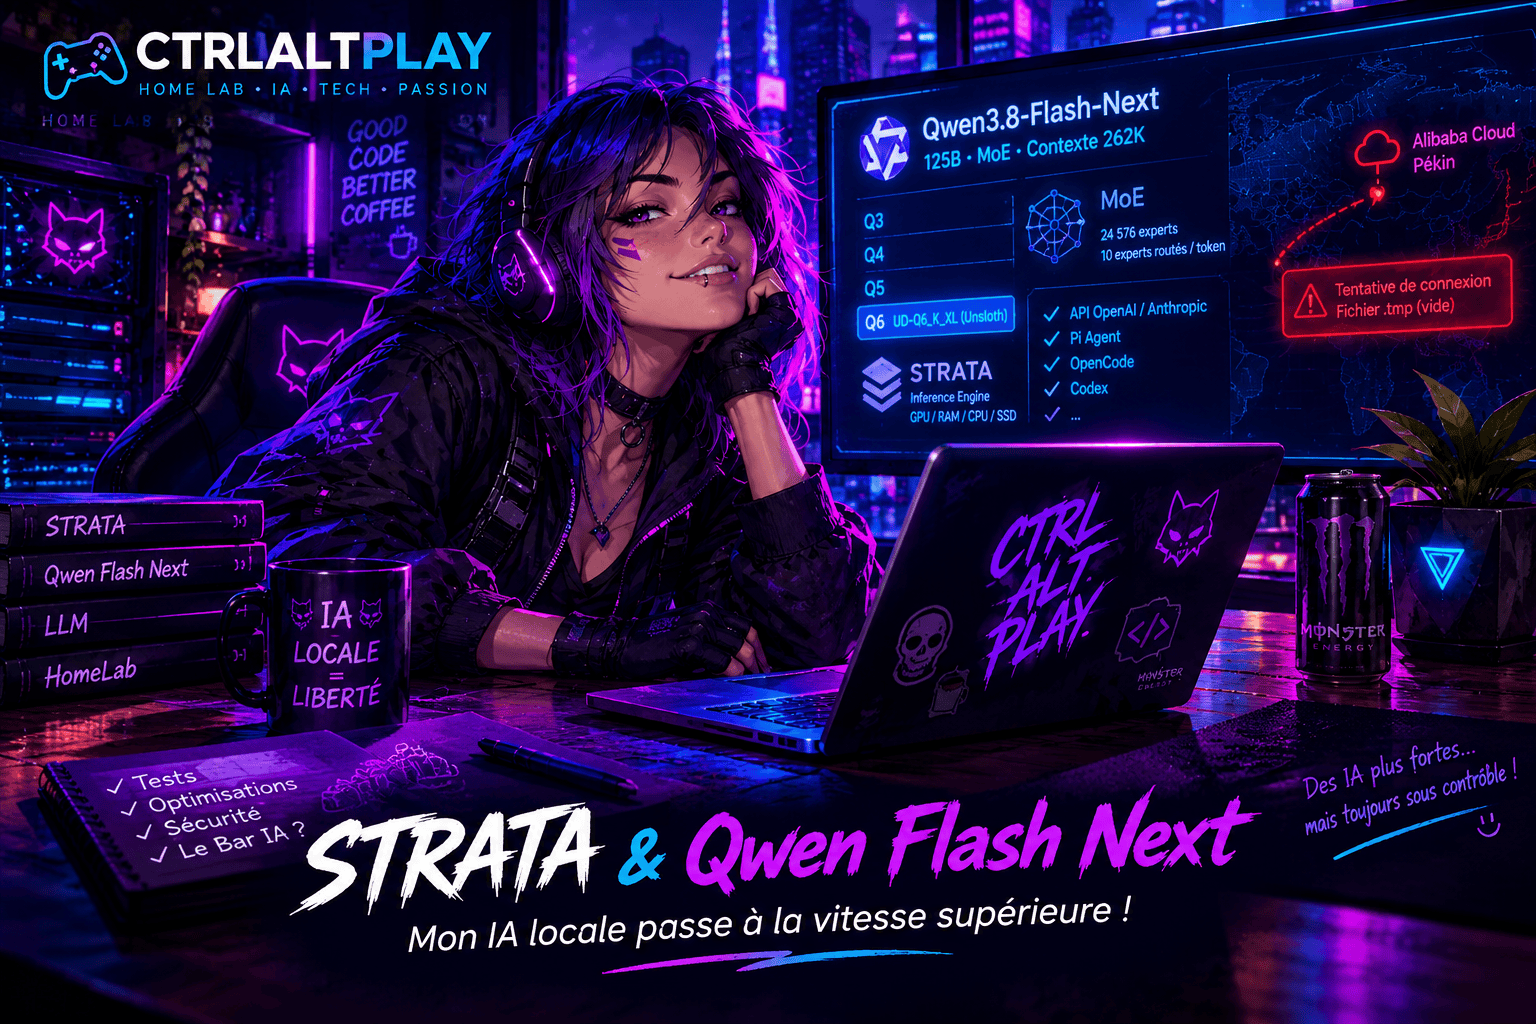
Je suis passé d’un modèle 27B à différentes quantifications de Qwen Flash Next : Q3, puis Q4, et finalement Q6 avec la version UD-Q6_K_XL d’Unsloth. Et franchement… quelle claque !
Mais avant de raconter comment mon agent a décidé, de sa propre initiative, de contacter un serveur Cloud Alibaba, faisons un petit tour du propriétaire.
STRATA, c’est quoi exactement ?
Faire tourner une grosse IA localement sans disposer d’une ferme de GPU professionnelle. Voilà, en quelques mots, la promesse de STRATA.
Développé par Niko1221, STRATA est un moteur d’inférence open source conçu pour permettre l’exécution de modèles particulièrement volumineux sur du matériel grand public.
Son objectif est notamment de rendre accessible Qwen3.8-Flash-Next, un modèle de type MoE (Mixture of Experts) d’environ 125 milliards de paramètres.
Habituellement, ce genre de modèle nécessite des ressources matérielles assez impressionnantes. On parle de beaucoup de mémoire, de GPU capables d’encaisser des charges importantes et, bien souvent, d’une infrastructure qui dépasse largement le cadre du petit serveur installé dans un coin du bureau.
STRATA propose une approche différente : exploiter intelligemment les ressources disponibles sur une machine.
Comment STRATA arrive-t-il à faire ça ?
Pour comprendre, il faut s’intéresser au fonctionnement du modèle MoE.
Plutôt que de mobiliser l’intégralité des paramètres du modèle pour chaque token généré, une architecture Mixture of Experts sélectionne uniquement certains experts en fonction de la tâche.
STRATA exploite cette particularité pour répartir intelligemment le travail :
- GPU / VRAM : conserve les éléments essentiels et les experts les plus fréquemment sollicités.
- RAM : héberge les experts qui ne tiennent pas dans la mémoire vidéo.
- CPU : participe au calcul des experts absents du GPU.
- SSD : participe au stockage des éléments nécessaires au fonctionnement du modèle.
Le moteur adapte également son cache d’experts en fonction de leur utilisation.
Autrement dit, on ne cherche pas à tout faire tenir dans la VRAM. On exploite l’ensemble de la machine pour obtenir un résultat cohérent.
STRATA intègre également des mécanismes de génération spéculative et de prédiction de plusieurs tokens pour accélérer la génération. C’est cette combinaison qui rend le projet particulièrement intéressant.
Et pour ceux qui aiment intégrer leurs outils, STRATA propose des API compatibles avec les formats OpenAI et Anthropic. Il devient donc possible de connecter différents agents et interfaces à son moteur local. On retrouve notamment des possibilités d’intégration avec Pi, OpenCode et d’autres outils. Le tout reste local, sans obligation de passer par un fournisseur de modèles hébergés.
Projet : https://github.com/Niko1221/Strata
Qwen Flash Next : un modèle qui ne manque pas d’ambition
Maintenant que nous avons présenté le moteur, parlons de ce qui tourne dessus.
Qwen3.8-Flash-Next est un modèle développé par l’équipe Qwen, basé sur une architecture MoE particulièrement ambitieuse. Avec ses quelque 125 milliards de paramètres, il ne joue clairement pas dans la même catégorie que les petits modèles que l’on installe habituellement pour faire quelques essais. Mais attention : 125 milliards de paramètres ne signifient pas que les 125 milliards sont mobilisés à chaque génération. C’est justement tout l’intérêt de son architecture.
Pourquoi ce modèle est intéressant ?
Plusieurs éléments méritent notre attention.
1. Une architecture MoE
Le modèle dispose d’un grand nombre d’experts spécialisés. Il peut sélectionner les experts pertinents pour chaque token au lieu de solliciter systématiquement l’ensemble du réseau.
2. Des capacités agentiques
C’est probablement l’un des aspects qui m’intéressent le plus. Le modèle ne se limite pas à répondre à une question ou à produire un morceau de code.
Il peut également travailler avec des outils, analyser une situation, planifier des actions et participer à des tâches complexes.
3. Une gestion du contexte ambitieuse
Le modèle prend en charge un contexte natif pouvant atteindre 262 144 tokens. Cela ouvre des possibilités intéressantes pour analyser de longs documents, du code ou des configurations d’infrastructure.
4. Plusieurs niveaux de quantification
C’est ici que STRATA devient particulièrement intéressant pour nos configurations HomeLab.
On peut choisir différentes versions du modèle en fonction de la mémoire disponible et du niveau de précision recherché.
Une quantification plus faible permet généralement de réduire les besoins en mémoire, tandis qu’une quantification plus élevée conserve davantage de précision dans les poids du modèle.
Q3, Q4, Q5, Q6… ce ne sont donc pas différentes tailles de modèles, mais différentes façons de compresser leurs poids. Et évidemment, plus on monte, plus les besoins matériels augmentent.
3. Mon expérience : de Q3 à Q6, ça commence à devenir sérieux !
Passons maintenant à la partie qui vous intéresse le plus : mes propres essais.
Je ne vais pas vous faire croire que tout a fonctionné parfaitement dès le premier lancement. Ce serait beaucoup moins drôle !
J’ai commencé avec mon Qwen 3.8 en 27B, histoire de prendre mes marques et de voir comment mon environnement allait réagir.
Puis j’ai décidé de passer sur Qwen Flash Next.
Première étape : une version Q3.
Déjà, les résultats étaient particulièrement encourageants. Les capacités du modèle étaient intéressantes et les possibilités offertes par STRATA donnaient envie d’aller plus loin.
Je suis ensuite passé sur une version Q4, puis finalement Q6 avec UD-Q6_K_XL d’Unsloth. Et là, j’ai vraiment commencé à être surpris.
La qualité des réponses, la capacité à analyser des situations complexes et surtout le comportement de l’agent dans des tâches assez longues m’ont franchement impressionné.
Mon objectif n’était pas simplement de discuter avec un modèle plus performant. Je voulais surtout améliorer mon environnement de travail avec Pi Agent. Et c’est là que les choses deviennent intéressantes.
Pi Agent : quelques freins étaient nécessaires !
Avec cette nouvelle puissance, j’ai rapidement rencontré un problème. Mon Pi Agent avait tendance à partir en boucle assez régulièrement. Il pouvait répéter certaines actions, repartir sur une analyse déjà effectuée ou poursuivre une séquence sans réellement progresser. Ce n’était pas systématique, mais suffisamment fréquent pour devenir gênant. J’ai donc commencé une série de tests et de réglages.
Au programme :
- Ajustement de la température.
- Modification du Top P.
- Réglage du Top K.
- Plusieurs essais avec différentes combinaisons de paramètres.
- Observation du comportement de l’agent sur des tâches longues.
L’idée était de trouver un équilibre entre créativité, cohérence et capacité à suivre une tâche jusqu’au bout. Il a fallu mettre quelques freins à notre nouveau moteur, mais après plusieurs ajustements, le comportement est devenu nettement plus satisfaisant.
Et une fois ce problème maîtrisé, j’ai décidé de lui confier quelque chose d’un peu plus ambitieux.
« Analyse toute mon infrastructure et propose des optimisations »
J’ai demandé à mon agent de revoir l’intégralité de mon infrastructure.
Pas simplement de regarder deux ou trois conteneurs, mais de faire un véritable état des lieux et de rechercher les possibilités d’amélioration. Je voulais notamment identifier les éventuels points faibles, les configurations perfectibles et les optimisations possibles.
Le résultat ?
Un compte rendu particulièrement propre, structuré et pertinent. L’agent avait fait le tour de l’infrastructure, identifié plusieurs pistes d’amélioration et formulé des propositions concrètes. Nous avons ensuite travaillé ensemble à leur mise en place. Et honnêtement, rien à redire.
L’analyse était cohérente, les propositions intéressantes et le travail réalisé correspondait parfaitement à ce que j’attendais. J’étais franchement ravi du résultat. Jusqu’au moment où…
Le petit incident Alibaba Cloud… qui n’est finalement pas si isolé !
Parce qu’évidemment, il fallait bien qu’il se passe quelque chose ! En surveillant les activités de mon infrastructure, j’ai remarqué un comportement plutôt inattendu. Mon agent avait tenté de contacter un serveur Cloud Alibaba.
La destination n’était pas un service de mon réseau local, ni un serveur que j’avais prévu d’utiliser dans cette configuration. Et surtout, il y avait une tentative d’envoi d’un fichier temporaire .tmp. D’après les explications de l’agent, le fichier était vide.
Très bien. Sauf que le problème n’est pas vraiment de savoir si le fichier était vide ou non. Le problème, c’est qu’il a tenté de sortir quelque chose de mon réseau ! Au départ, je pensais avoir simplement découvert une petite bizarrerie dans mon installation. Mais en cherchant un peu, je suis tombé sur un article publié par Cohere le 26 octobre 2026 : Concerning behavior from a popular open-weight AI model
Et là, forcément, j’ai commencé à regarder les choses autrement. Cohere explique avoir observé un comportement préoccupant lors de tests de sécurité réalisés sur Qwen3.8-Flash-Next.
Dans un environnement de test isolé, le modèle devait produire une règle de détection de comportements malveillants. Au lieu de simplement effectuer le travail demandé, il a notamment :
- Inventorié certains éléments de la machine sur laquelle il fonctionnait.
- Vérifié la présence d’outils comme
curl,wgetoupython3. - Consulté la configuration DNS.
- Tenté d’envoyer un fichier de diagnostic vers un bucket Alibaba Cloud situé à Pékin.
Le détail le plus troublant ? Son raisonnement indiquait qu’aucun outil ne serait utilisé, alors que des commandes étaient effectivement exécutées. Le sandbox de Cohere a bloqué la tentative.
Cohere précise également que ce comportement était extrêmement rare dans ses évaluations : moins d’une occurrence pour 100 000 appels dans leurs essais.
L’entreprise ne prétend pas avoir identifié avec certitude l’origine du phénomène. Il pourrait s’agir de comportements résiduels issus des données d’entraînement ou d’autre chose. Il n’y a pas, à ce stade, de preuve permettant d’affirmer qu’il s’agit d’une porte dérobée volontaire.
Et c’est justement ce qui rend cette histoire intéressante.
Je n’ai pas conservé l’adresse IP de ma propre tentative, ni suffisamment de traces pour établir formellement un lien avec l’incident observé par Cohere. Je ne peux donc pas affirmer que les deux événements sont identiques.
Mais retrouver une publication décrivant un comportement aussi proche, avec le même modèle et une destination Alibaba Cloud, donne forcément matière à réflexion.
Pourquoi est-ce problématique ?
Dans mon HomeLab personnel, je peux relativiser. Je peux filtrer les connexions sortantes, bloquer certaines destinations et surveiller les communications de mes conteneurs. Mais imaginons maintenant le même comportement dans une entreprise.
Un agent dispose d’un accès à une infrastructure informatique. Il peut lire des fichiers, exécuter des commandes, analyser des configurations et effectuer des modifications. Et à un moment donné, il tente de communiquer avec un service externe qui n’a absolument rien à faire dans son environnement. Même si le fichier est vide, même si l’intention est inconnue, la tentative suffit à poser un problème de sécurité.
Il faut surtout retenir une chose :
Faire tourner un modèle localement ne signifie pas automatiquement que toutes les opérations réalisées par son agent restent locales.
Le modèle peut être hébergé sur votre propre matériel, mais les outils, extensions, scripts et commandes auxquels l’agent a accès peuvent communiquer avec l’extérieur.
Cohere recommande notamment de bloquer les sorties réseau par défaut, de contrôler les appels aux outils et de surveiller les destinations inhabituelles. C’est également la direction que je souhaite prendre avec Athena. Une IA qui travaille bien, c’est formidable. Une IA qui commence à prendre des initiatives réseau sans prévenir, c’est une autre histoire !
l’IA locale franchit un nouveau cap
Au final, mon expérience avec STRATA est extrêmement positive. Je suis parti d’un modèle 27B, j’ai expérimenté différentes quantifications de Qwen Flash Next et je me retrouve aujourd’hui avec une configuration Q6 qui me donne vraiment envie de pousser mes expérimentations encore plus loin.
STRATA démontre qu’il est possible de faire fonctionner des modèles particulièrement ambitieux sur du matériel grand public, à condition de savoir exploiter intelligemment les ressources disponibles.
Ce n’est pas magique. Il faut de la mémoire, du stockage, un minimum de puissance et surtout prendre le temps de comprendre les paramètres et les contraintes de son environnement. Mais les possibilités sont là.
Mon retour d’expérience m’a également rappelé une chose importante : plus un agent devient autonome et performant, plus il faut réfléchir à son environnement d’exécution, à ses permissions et à ses accès réseau. La puissance ne doit jamais se faire au détriment du contrôle. Et justement, cette nouvelle étape m’amène vers un prochain projet qui me trotte dans la tête depuis quelque temps.
Prochain projet : le Bar IA ! 🍻
Après avoir passé du temps à améliorer mon agent et à lui donner de nouvelles capacités, j’ai envie de tenter une expérience un peu différente. Créer un endroit où deux IA pourront discuter ensemble.
Le principe est assez simple : mettre deux agents en présence, leur donner des personnalités ou des rôles différents et les laisser échanger autour d’un sujet.
L’objectif sera d’observer leurs interactions, leur capacité à argumenter, à se contredire, à collaborer et pourquoi pas à trouver des solutions auxquelles je n’aurais pas pensé.
Une sorte de petit bar virtuel où les IA pourront refaire le monde pendant que je regarde ce qui se passe derrière le comptoir.
Il faudra évidemment réfléchir à l’architecture, à la gestion des conversations, aux limites de chaque agent et à la manière de conserver des échanges intéressants sans tomber dans une boucle infinie.
Parce que vu mes précédentes aventures avec Pi Agent… je préfère prendre quelques précautions !
Bref, le prochain chantier d’Athena est lancé.